ScanOps
26.03 ~ 진행 중
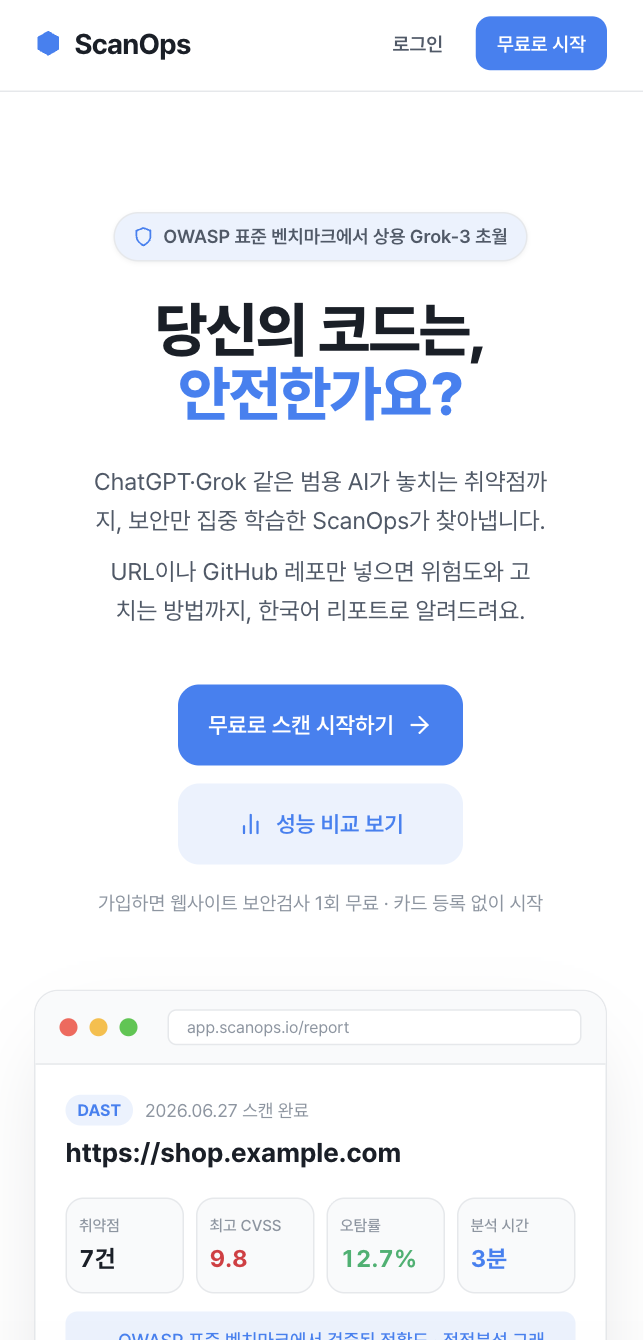
AI가 생성한 코드까지 검증할 수 있는 보안 분석 서비스를 직접 기획한 졸업과제·창업 프로젝트입니다. 초기 LLM 중심 접근에서 출발해, 논문을 참고하며 CPG(Code Property Graph)의 구조 분석과 LLM의 의미 판단을 결합하는 방향으로 설계를 수정했습니다.
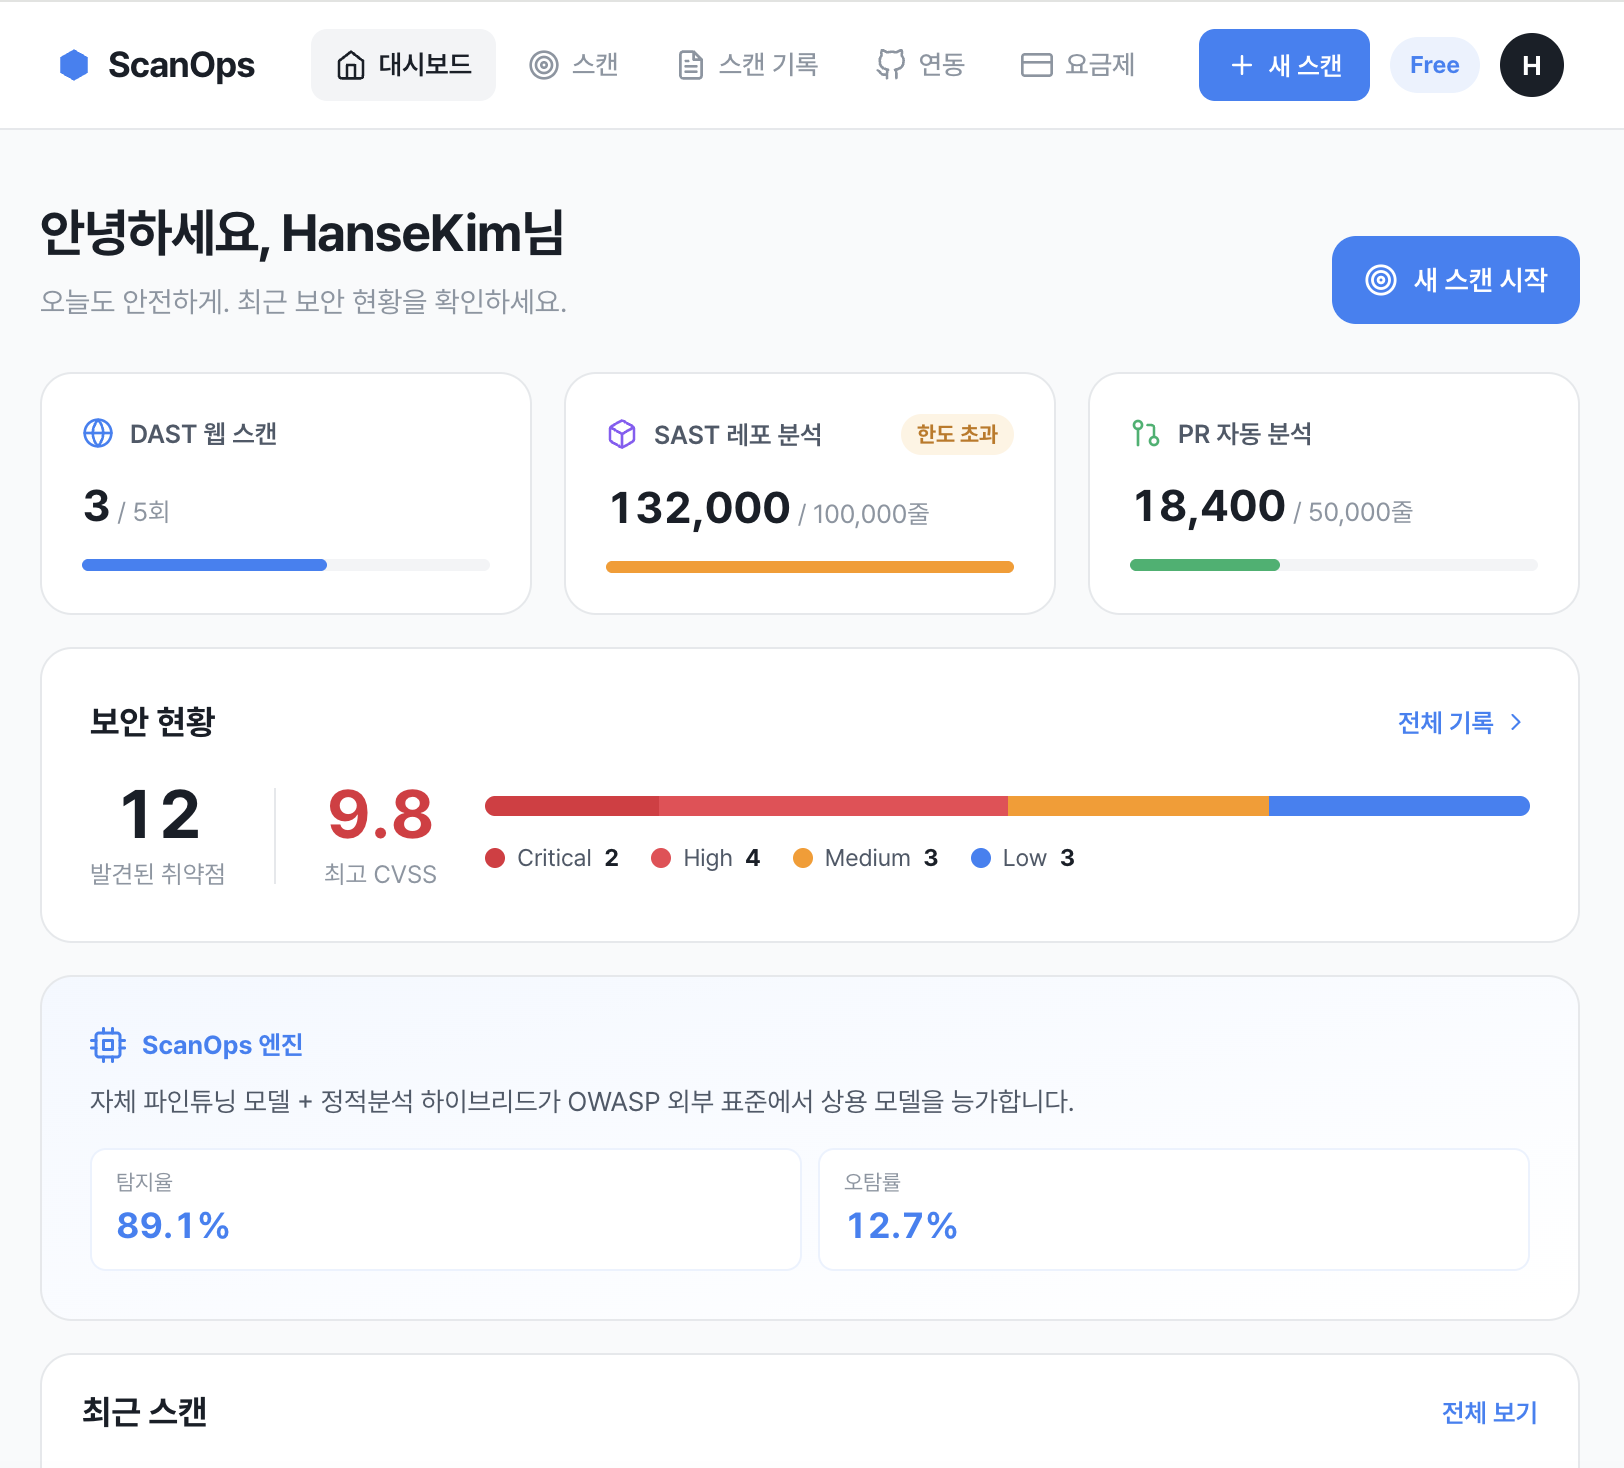
디지털서비스 기획 관점에서는 개발자의 보안 검증 부담을 문제로 정의하고, GitHub PR 분석과 취약점 리포트로 연결하는 서비스 방향을 구체화했습니다. 분석 방식의 선택뿐 아니라 결과를 어떤 지표로 검증할지 판단한 경험입니다.
내가 맡은 역할과 AI 활용
문제 정의, 방법 선정, 평가 기준 수정, 결과 검토를 맡았습니다. 코드 작성은 Codex와 Claude가 담당했습니다. 방법을 선정하고 결과를 해석할 때에도 AI의 설명과 의견을 참고하면서, 비교할 대안과 확인할 지표를 정하고 방향을 수정했습니다.
LLM 내부 원리를 충분히 이해한 상태에서 시작한 프로젝트는 아닙니다. 따라서 모델 자체를 독자적으로 개발한 경험과 구분하여, 서비스 기획과 분석 방식의 선택·평가를 수행한 경험으로 소개합니다.
- 문제 정의: 코드 생성 속도가 빨라지는 만큼 개발 과정의 보안 검증 부담을 줄이는 서비스를 기획했습니다.
- 방법 선정: LLM 단독 분석의 한계를 검토하고, 관련 논문의 CPG + LLM 접근을 참고해 아키텍처 변경을 주도했습니다.
- 평가 기준 수정: AI가 F1 중심으로 성과를 설명하는 것에 의문을 갖고, 재현율·정밀도·오탐률·MCC를 함께 확인하도록 했습니다.
- 결과 검토: 성능이 개선된 항목뿐 아니라 증가한 오탐과 탐지하지 못한 유형을 함께 해석했습니다.
- 창업 활동: 모두의창업 1라운드 진출, 부울경 예비창업가 트랙 최우수상.
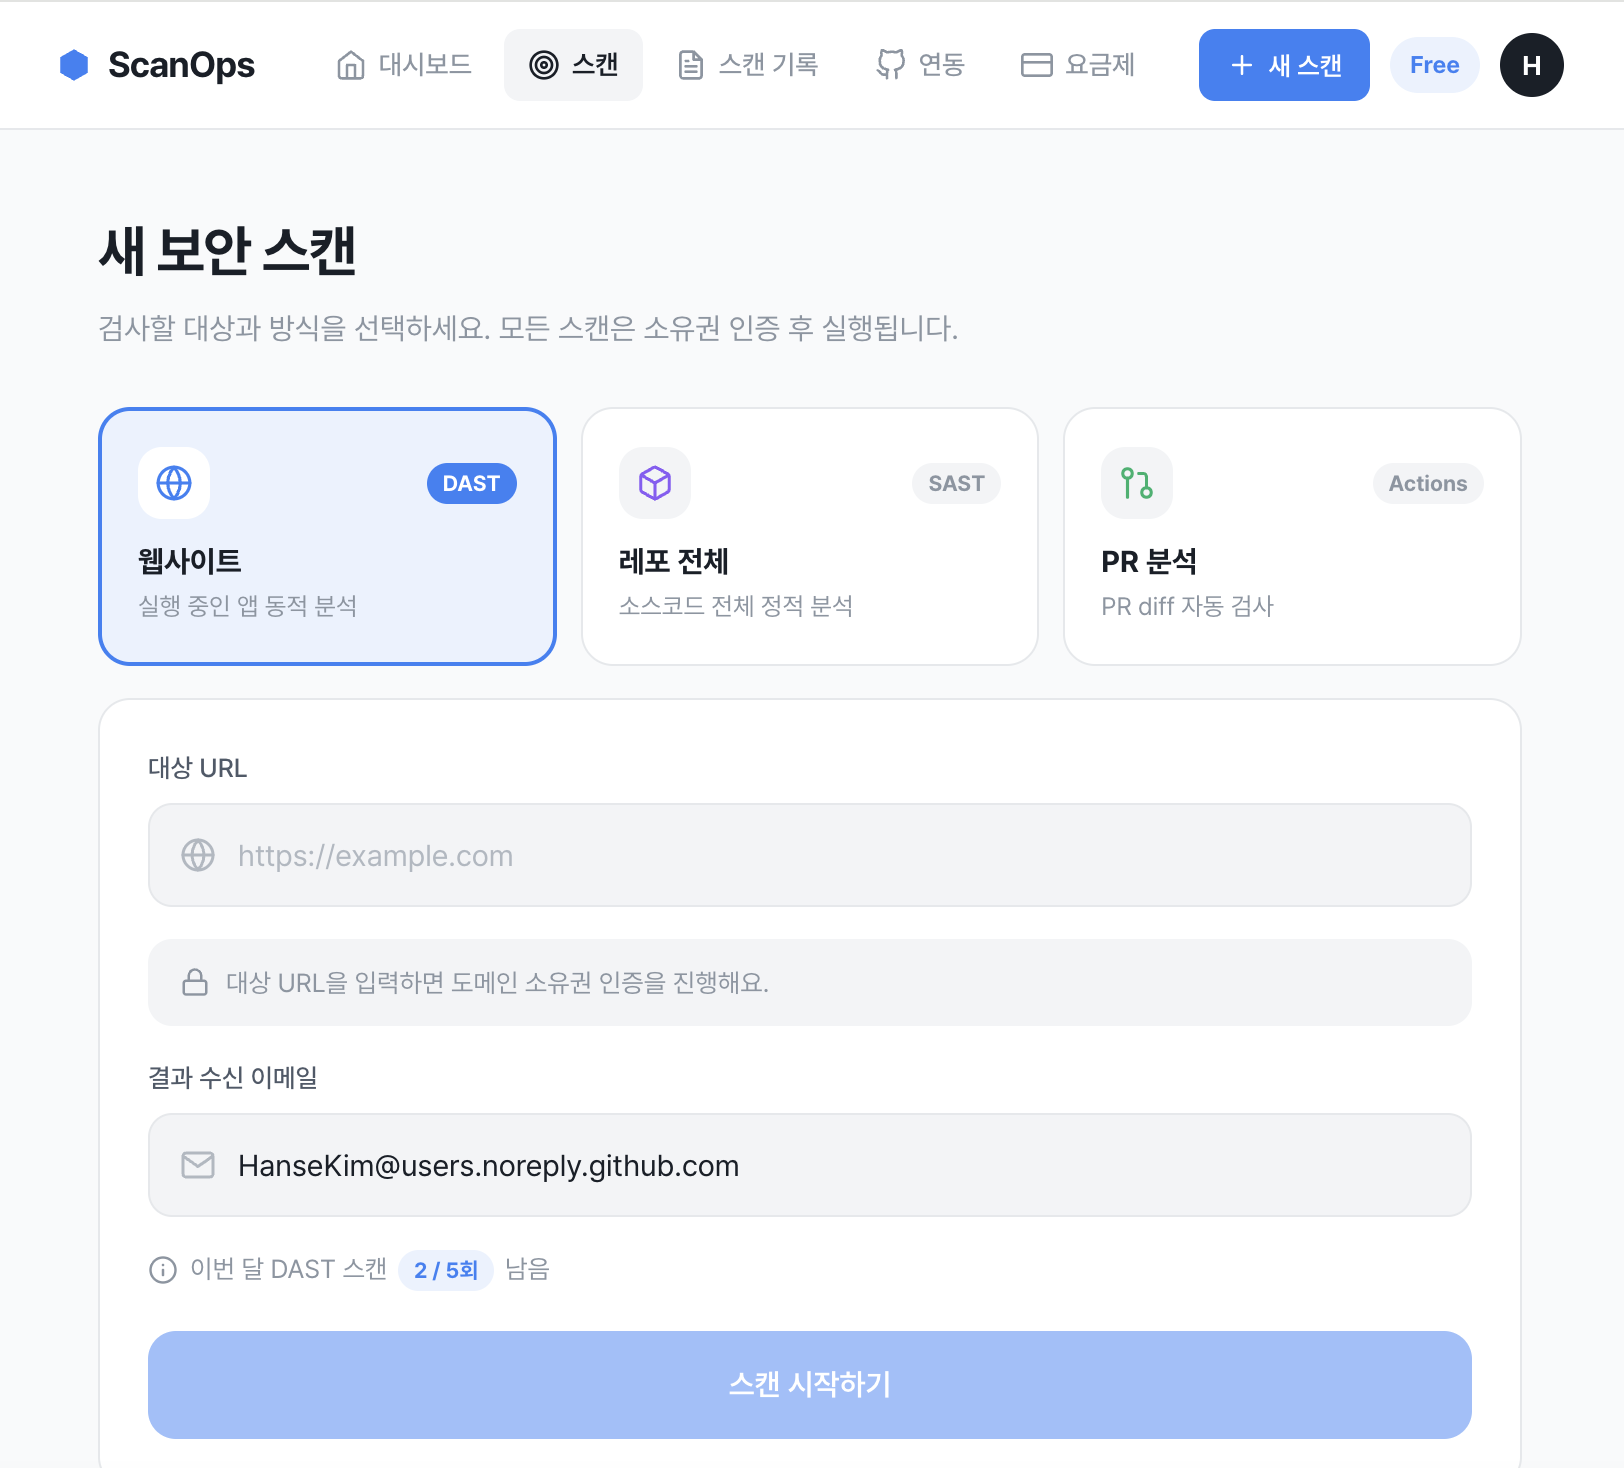
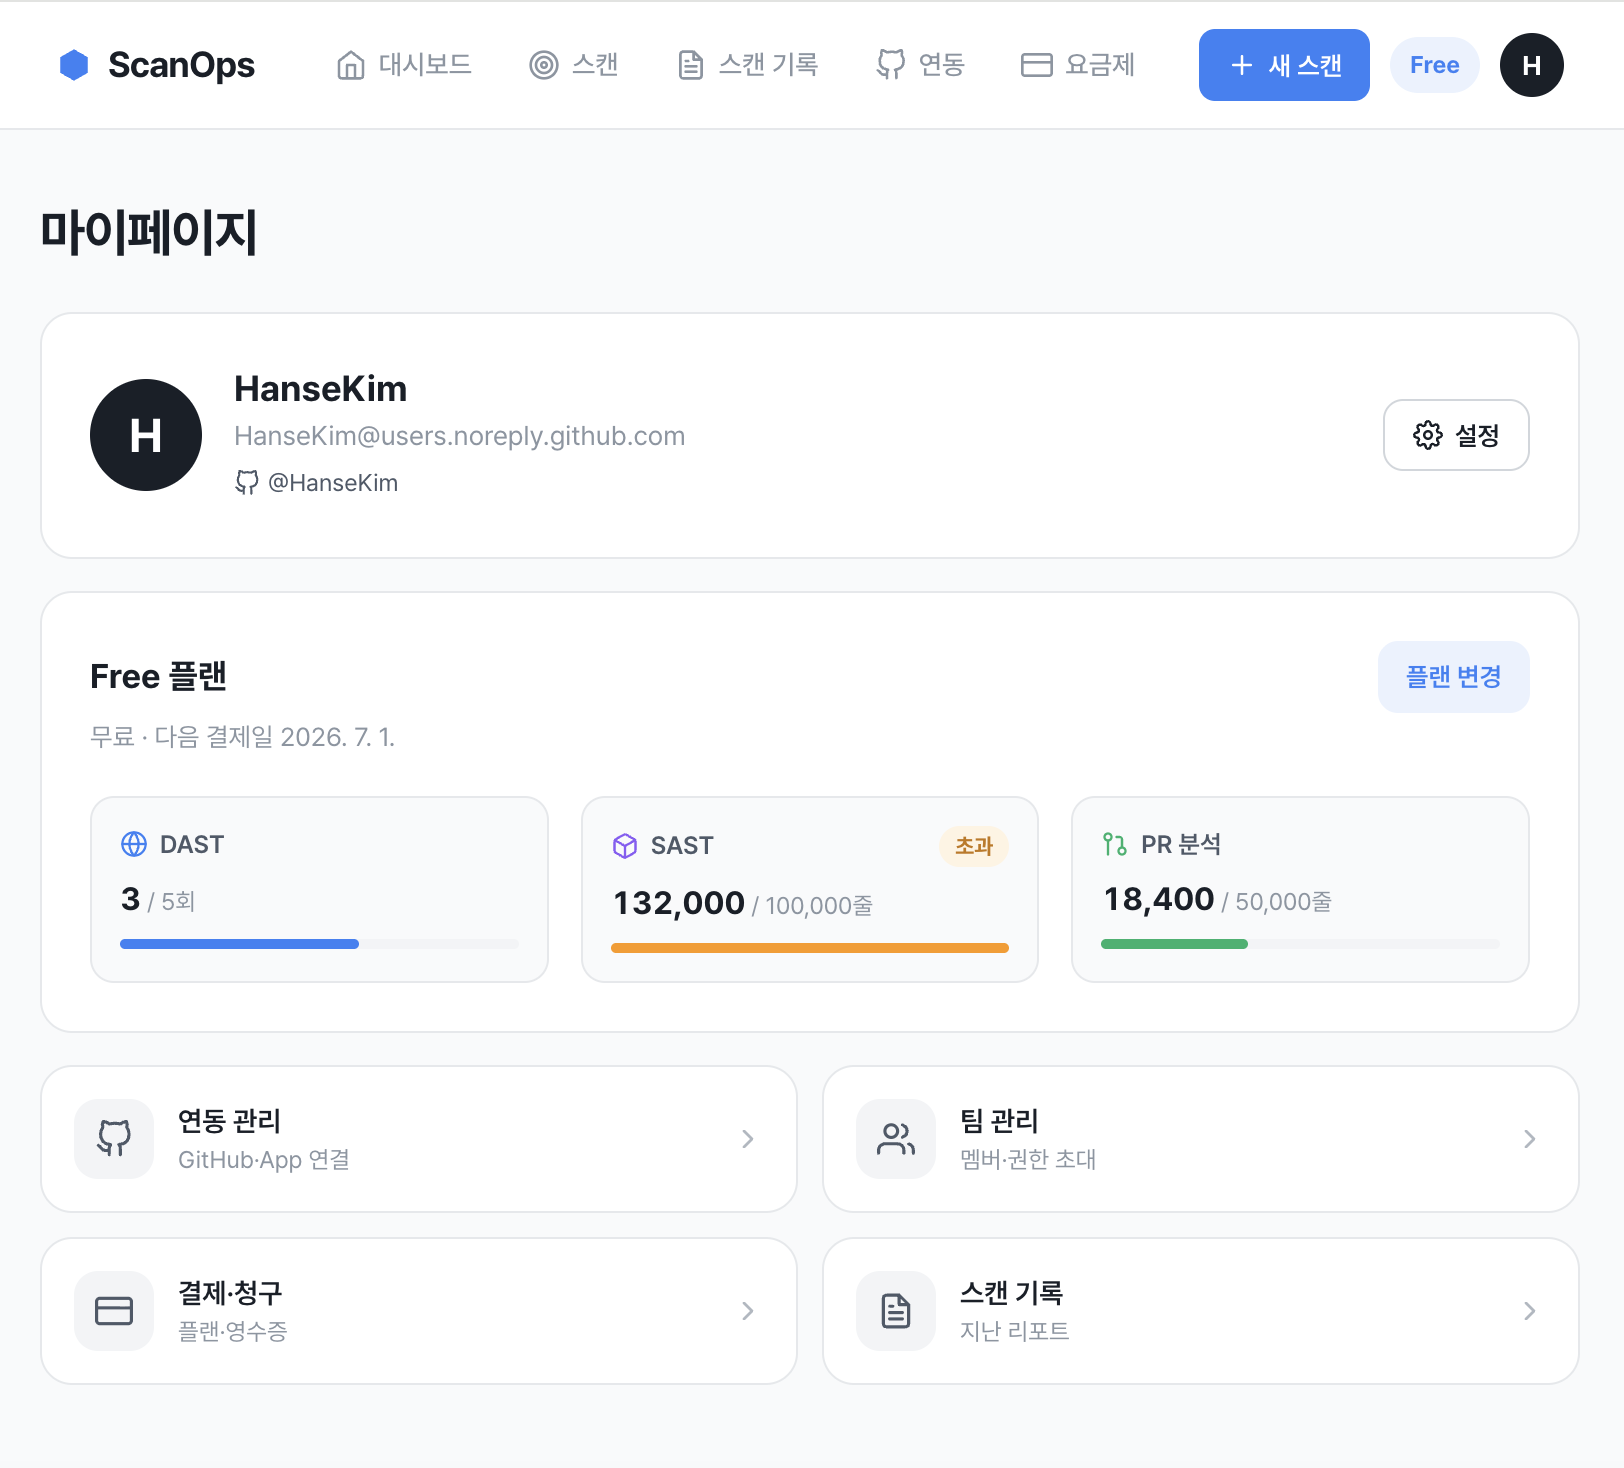
서비스 화면
분석 방식
Joern으로 Java 코드의 CPG를 생성하고, 입력 지점(source)에서 위험 동작(sink)까지 이어지는 경로를 분석합니다. 고정 규칙으로 다루기 어려운 외부 API는 LLM이 source/sink 역할과 규칙 후보를 제안하도록 구성했습니다.
벤치마크 실험은 기존 CPG 규칙에 LLM 생성 규칙을 추가하는 효과를 비교합니다. 서비스 구성에서는 CPG 경고와 LLM의 소스코드 의미 분석 결과를 함께 보존하고, CWE·행 번호를 기준으로 통합합니다. 아래 실험 결과를 서비스 전체의 탐지 성능으로 해석하지 않습니다.
- 프론트엔드: React, TypeScript, Vercel
- 백엔드: Java, Spring Boot, PostgreSQL
- 분석 엔진: Python, FastAPI, Joern CPG, Qwen 계열 LLM
- 웹 동적 분석: OWASP ZAP
- 연동: GitHub 저장소·PR 분석, 취약점 리포트와 수정 가이드
평가 조건
2026년 졸업과제 포스터에 정리한 실험 결과입니다. 초기 QLoRA·OWASP 실험과 구분하여, 현재의 Java CPG + LLM 규칙 보강 실험을 제시합니다.
- 데이터: NIST Juliet Java 1.3, 취약 코드와 안전 코드 50:50
- 전처리: 중복 제거 및 답을 드러내는 표지 중립화
- 분할: 개발용 190쌍, 평가용 534쌍(1,068개 코드)
- 범위: CWE 38종, 고정 규칙 미구현 유형도 전체 평가에 포함
- 비교: 기존 CPG 규칙, CPG + LLM 생성 규칙, LLM 단독, CodeQL
- 조건 차이: LLM 단독에는 탐지할 CWE 유형을 미리 제공했습니다. 일반적인 미지의 취약점 탐지 조건과 다릅니다.
전체 38종 평가 결과
| 탐지 방식 | 정밀도 | 재현율 | F1 | 오탐률 | MCC |
|---|---|---|---|---|---|
| 기존 CPG 규칙 | 77.4% | 27.0% | 0.400 | 7.9% | 0.252 |
| CPG + LLM 생성 규칙 | 72.6% | 34.3% | 0.466 | 12.9% | 0.251 |
| LLM 단독 · 대상 CWE 사전 제공 | 82.6% | 95.1% | 0.884 | 20.0% | 0.760 |
| CodeQL | 74.2% | 21.5% | 0.334 | 7.5% | 0.199 |
LLM 규칙 보강으로 재현율은 27.0% → 34.3%, F1은 0.400 → 0.466으로 증가했습니다. 동시에 오탐률은 7.9% → 12.9%로 높아졌고 정밀도는 하락했으며 MCC는 거의 변하지 않았습니다. 따라서 전반적인 우월성보다 탐지 범위 확대와 오탐 증가 사이의 절충으로 해석합니다.
취약점 유형별로 본 한계
- 고정 규칙으로 찾는 7종: 두 방식 모두 이 평가 집합에서 재현율 100%, F1 1.000, 오탐률 0%였습니다. 전체 취약점에 대한 성능은 아닙니다.
- 데이터 흐름 추적이 필요한 14종: 규칙 보강 후 재현율 20.0% → 34.8%, F1 0.286 → 0.435로 증가했지만, 오탐률도 20.0% → 25.2%로 높아졌습니다.
- 고정 규칙 미구현 17종: 규칙 보강 후에도 재현율은 3.6%에 그쳤습니다. 전체 평가에서 제외하지 않았습니다.
탐지 결과가 없는 경우 정밀도를 산출할 수 없으며, MCC의 분모가 0인 경우 평가 코드에서는 0으로 처리했습니다. 합성 벤치마크의 결과이므로 실제 프로젝트에서 같은 성능을 보장하지 않습니다. 실제 취약점 사례 검증과 Java 외 언어 확장은 향후 과제입니다.
이 경험에서 배운 점
결과가 좋아 보인다는 설명을 그대로 받아들이기보다, 어떤 오류를 놓쳤는지와 어떤 조건에서 비교했는지를 묻는 것이 중요했습니다. 데이터 누수는 학습·개발 과정에 평가 정보가 유입되는 문제이고, 과적합은 학습 데이터에 지나치게 맞춰 일반화가 떨어지는 문제이므로 구분해서 검토해야 합니다.
앞으로는 실험 설정과 실행 기록을 더 체계적으로 남기고, 제안된 방법의 원리와 실패 사례를 직접 설명할 수 있는 깊이를 쌓고자 합니다.
프로젝트 정보
- 팀: ScanOps · 부산대학교 졸업과제
- 결과 출처: 「CPG와 대규모 언어모델을 결합한 소스코드 보안 취약점 탐지 시스템」, 2026 정보컴퓨터공학부 졸업과제 발표회 포스터
- GitHub
- GitHub App
- 서비스 데모